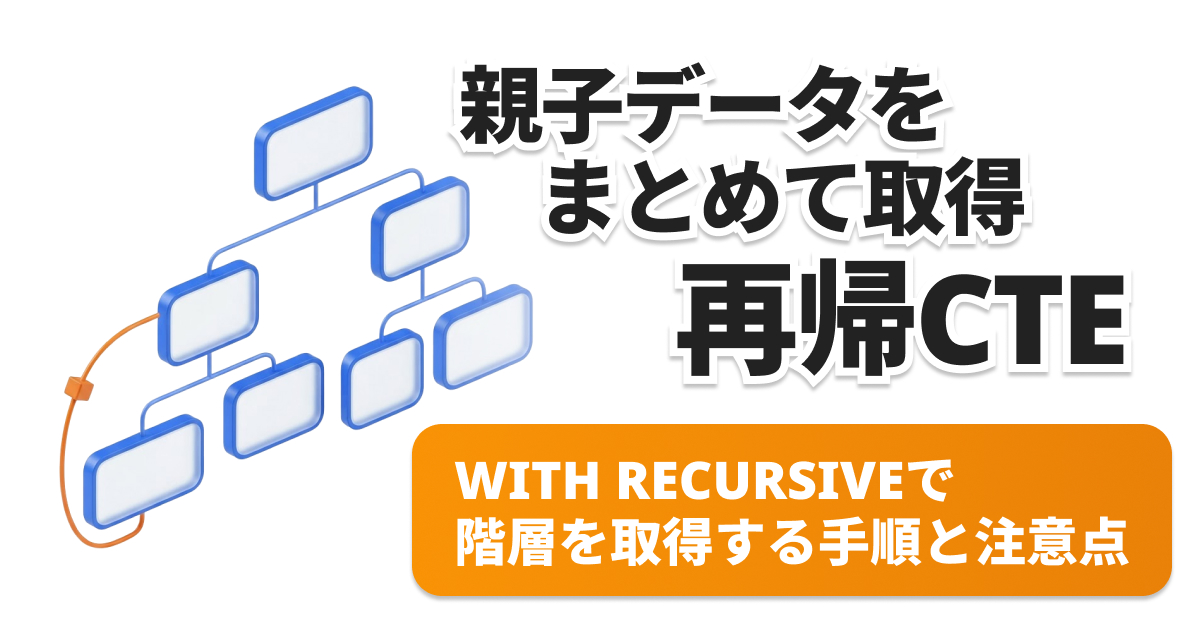
親子関係を持つカテゴリや部署をSQLで階層的に取得するには、WITH RECURSIVEを使います。最初の親を取得する「起点SELECT」と、その子を繰り返し探す「再帰SELECT」をUNION ALLでつなぐのが基本です。循環した参照データでは処理が終わらないおそれがあるため、PostgreSQL 14以降ならCYCLE句などで循環を検出し、必要に応じて最大深さも制限します。ここではPostgreSQLで書き方を確認します。
WITH RECURSIVEは起点と再帰処理を組み合わせる
再帰CTEは、既に取得した行の値を使って次の行を探すSQLです。組織ツリー、カテゴリ階層、部品表など、親子関係が繰り返されるデータに向いています。
| 部分 | 役割 | 例 |
|---|---|---|
| 起点(非再帰項) | 探索開始行を取得 | 親がない最上位カテゴリや指定id |
| UNION ALL | 起点と再帰結果を結合 | 階層を繰り返し増やす |
| 再帰項 | 直前に得た親に紐づく子を取得 | c.parent_id = t.id |
| 終了条件 | 次に一致する子がなくなれば終了 | 子がない葉ノードなど |
用語解説:CTE(共通テーブル式)
WITHで定義してクエリ内から名前で参照できる一時的な結果集合。WITH RECURSIVEでは定義したCTEを再帰項から参照できます。
以下はPostgreSQL 18を参照した説明です。MySQLやSQL Serverでは使用できる再帰構文や循環検出の方法が異なるため、同じSQLをそのまま流用しないでください。
サンプルのカテゴリ階層を用意する
次の仮想データを想定します。id=1の「全社」を起点に、開発部と営業部、その下の子カテゴリを辿ります。まずテーブル設計とデータの関係を確認しましょう。
| id | parent_id | name |
|---|---|---|
| 1 | NULL | 全社 |
| 2 | 1 | 開発部 |
| 3 | 2 | Webチーム |
| 4 | 2 | インフラチーム |
| 5 | 1 | 営業部 |
| 6 | 5 | 法人営業 |
CREATE TABLE categories (
    id integer PRIMARY KEY,
    parent_id integer REFERENCES categories(id),
    name text NOT NULL
);

INSERT INTO categories (id, parent_id, name) VALUES
(1, NULL, '全社'),
(2, 1, '開発部'),
(3, 2, 'Webチーム'),
(4, 2, 'インフラチーム'),
(5, 1, '営業部'),
(6, 5, '法人営業');
CREATE TABLEとINSERTは検証用データの作成例です。実際の業務データベースに同名の表がある場合、そのまま実行しないでください。読み取り専用のSELECT例は次の節に示します。
再帰CTEで子孫をすべて取得するSQL
WITH RECURSIVE category_tree AS (
  SELECT id, parent_id, name, 0 AS depth
  FROM categories
  WHERE id = 1

  UNION ALL

  SELECT c.id, c.parent_id, c.name, t.depth + 1
  FROM categories AS c
  JOIN category_tree AS t
    ON c.parent_id = t.id
)
SELECT id, parent_id, name, depth
FROM category_tree
ORDER BY depth, id;
最初にid=1をdepth=0として返し、そこから子に一致する行を取得します。次の再帰でさらに孫へ進み、該当する子がなくなったときに終了します。
| id | name | depth |
|---|---|---|
| 1 | 全社 | 0 |
| 2 | 開発部 | 1 |
| 5 | 営業部 | 1 |
| 3 | Webチーム | 2 |
| 4 | インフラチーム | 2 |
| 6 | 法人営業 | 2 |
表示例はサンプルのデータ関係から導いた期待結果です。実データベースでSQLを動かして検証した結果ではありません。ORDER BY depth,idを指定しているため、階層の深さとIDで並べています。
SQLが終わらない原因とCYCLE句による対策
親子データに循環した参照があると、再帰処理が同じノードを繰り返してしまうことがあります。特にUNION ALLは重複を除外しないため、循環参照をそのまま辿るSQLには注意が必要です。
WITH RECURSIVE category_tree AS (
  SELECT id, parent_id, name, 0 AS depth
  FROM categories
  WHERE id = 1

  UNION ALL

  SELECT c.id, c.parent_id, c.name, t.depth + 1
  FROM categories AS c
  JOIN category_tree AS t
    ON c.parent_id = t.id
  WHERE t.depth < 20
)
CYCLE id SET is_cycle USING path
SELECT id, name, depth
FROM category_tree
WHERE NOT is_cycle
ORDER BY path;
PostgreSQL 14以降のCYCLE句は、同じIDを再訪したかを追跡するis_cycle列と経路を示すpath列を自動生成します。循環が検出されると、その経路の再帰をそこで止めます。ここでは深さの上限も20段とし、出力では循環行を除外しています。
深さ20という数値は説明用の安全上限です。実際の階層が21段以上ある場合は必要な行が欠けるので、業務上想定される深さを確認して設定してください。CYCLEをサポートしないDBでは同じ構文を使用できません。
UNIONとUNION ALL、LIMITの注意点
UNIONは同一の出力行を重複排除しますが、深さや経路が毎回変わる再帰では、循環があっても行全体は異なるため、UNIONに置き換えるだけで安全になるとは限りません。
| 工夫 | 得られること | 注意点 |
|---|---|---|
| UNION ALL | 再帰結果をそのまま加える | 循環の重複に注意 |
| UNION | 同一の行を重複除外 | depthが変われば循環防止できない |
| CYCLE | 訪問済みIDを検出 | 対応DBとバージョンが必要 |
| depth上限 | 再帰回数に上限を設ける | 深い正しい階層も途中で切れる |
| 外側SELECTのLIMIT | 返す行数を制限 | ORDER BYなどで中間結果全体が必要となる場合あり |
外側にLIMIT 10を付けたから無限再帰を確実に防げる、とは考えないでください。並び替えなどの処理によっては、途中結果が広く評価される場合があります。CYCLEや探索条件で根本的に止める方針を優先します。
深さ優先・幅優先と表示順を考える
階層の取得順と画面で見せる並びは別の問題です。PostgreSQLの再帰評価順に依存して順番を決めるのではなく、外側でORDER BYを指定します。
CYCLE句で作られるpathでソートすれば、経路に沿った並びにできます。深さごとにまとめたいならdepthとidで並べる方法が分かりやすいでしょう。PostgreSQL 14以降にはSEARCH DEPTH FIRST / BREADTH FIRSTもあり、明示的な順序列を作れます。
-- CYCLEで生成されたpathを利用する例
SELECT id, name, depth
FROM category_tree
WHERE NOT is_cycle
ORDER BY path;
この短いSQLは直前のCYCLE付きCTEの最後のSELECT部分だけを抜き出したものです。単独で実行してもcategory_treeは存在しません。
対象が欠ける・重複する場合の確認点
- 起点のWHERE id = 1が実際に存在するか。
- c.parent_id = t.idの列や型が正しいか。
- 親idに一致する子のレコードがあるか。
- カテゴリが複数の親を持つグラフ構造なら、経路ごとに同じノードが現れる場合がないか。
- depth上限で必要な階層を途中で打ち切っていないか。
- 再帰処理の性能が問題なら親参照列のインデックスを検討し、実行計画を確認する。
大量のレコードで実行する場合は、取得する起点と深さを限定した検証データから始めましょう。データの循環を検出した場合は、SQL側の回避に加えて参照データの整合性も確認することが重要です。
関連するSQL記事
通常のCTEやサブクエリとの違いを整理したい場合は、既存のSQLパフォーマンス記事が役立ちます。また再帰項のJOINが分からない場合は結合の基本を確認してください。
(CTEの考え方と通常のSQLについては『SQLサブクエリは遅い?JOIN・CTEとの違いと高速化のベストプラクティス』をご参照ください)
(親子テーブルを結合する基本については『SQL JOINの基本から実践まで|INNER・LEFT・RIGHT・OUTER JOINの違いをわかりやすく解説』をご参照ください)
よくある質問とまとめ
WITH RECURSIVEは全DBで同じように動きますか?
いいえ。基本の考え方は共通ですが、再帰の上限・CYCLE・SEARCHなどは製品とバージョンで異なります。本文はPostgreSQLを例にしています。
CYCLEがあればdepth上限は不要?
循環を検出する目的ではCYCLEが役立ちますが、想定外に非常に深い正しい階層を制限する必要がある場合は業務要件に沿った上限も検討します。
UNIONに変更するだけで無限再帰を防げますか?
出力行全体が同一である場合は重複排除が働きます。しかしdepthのように値が変化する列があると止まらないため、確実な対策とは限りません。
再帰CTEは、起点と子を探す再帰SELECTをつないで階層データを取得する方法です。動作確認は少数のサンプルから始め、循環検出と深さ制限を設け、表示順を明示してください。
親子テーブルを使った小さな検証DBで、起点とdepthの変化、CYCLEによる終了を確かめてください。